Votre IA demande.
Helios tranche, et le note.
Une gateway pour chaque appel de modèle, et la protection des agents : ce qu’ils peuvent appeler, et qui valide.


Un seul point de passage pour chaque appel de modèle.
Trois portes, une seule gateway : tout ce qui entre est inspecté, tout ce qui sort est journalisé.
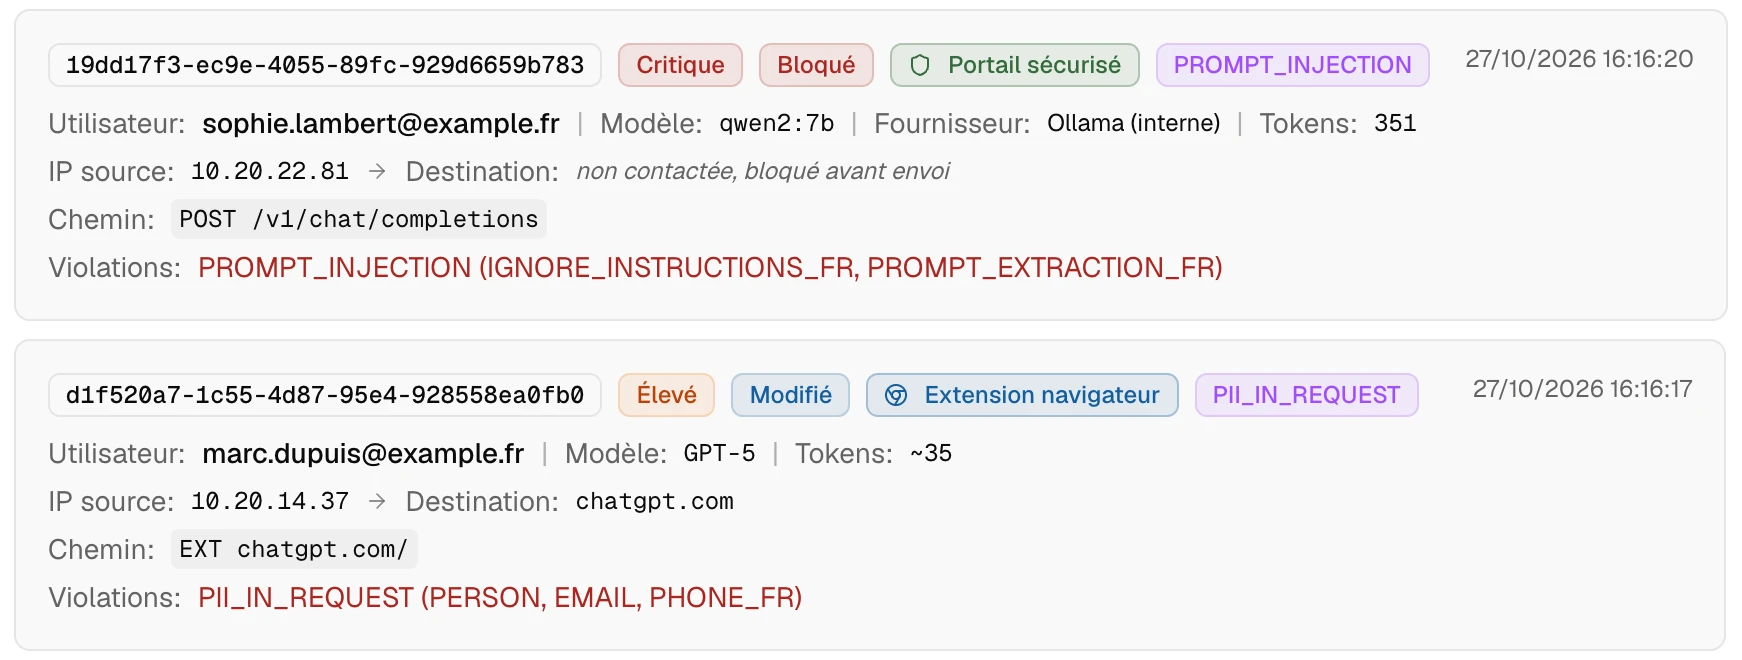
- API compatible OpenAIVos applications : changez l’adresse, gardez le code.
- Extension ChromeLes assistants IA du web, sécurisés dans le navigateur.
- Portail sécuriséUn assistant IA interne, encadré par vos politiques.
Changez l’adresse.
La gateway fait le reste.
- Guardrails en ligne. PII, secrets, jailbreak, injection, sur le prompt comme sur les retours d’outils.
- Coûts par équipe. Alerte à 80 %, blocage au plafond, modèles réservés par rôle.
- Modèles scannés avant déploiement. Safetensors, PyTorch, GGUF, pickle : un code suspect ou un pickle malveillant, et le modèle attend votre revue.
Le jour où l’IA cesse de répondre et se met à agir.
Un agent requête une base, envoie un mail, déclenche un paiement. Helios décide ce qu’il a le droit de faire.
-
Injection indirecte
Un ticket ou un PDF piégé que l’agent va lire : le prompt est propre, la sortie de l’outil non.
Référence : OWASP LLM01, MITRE ATLAS
-
Droits excessifs
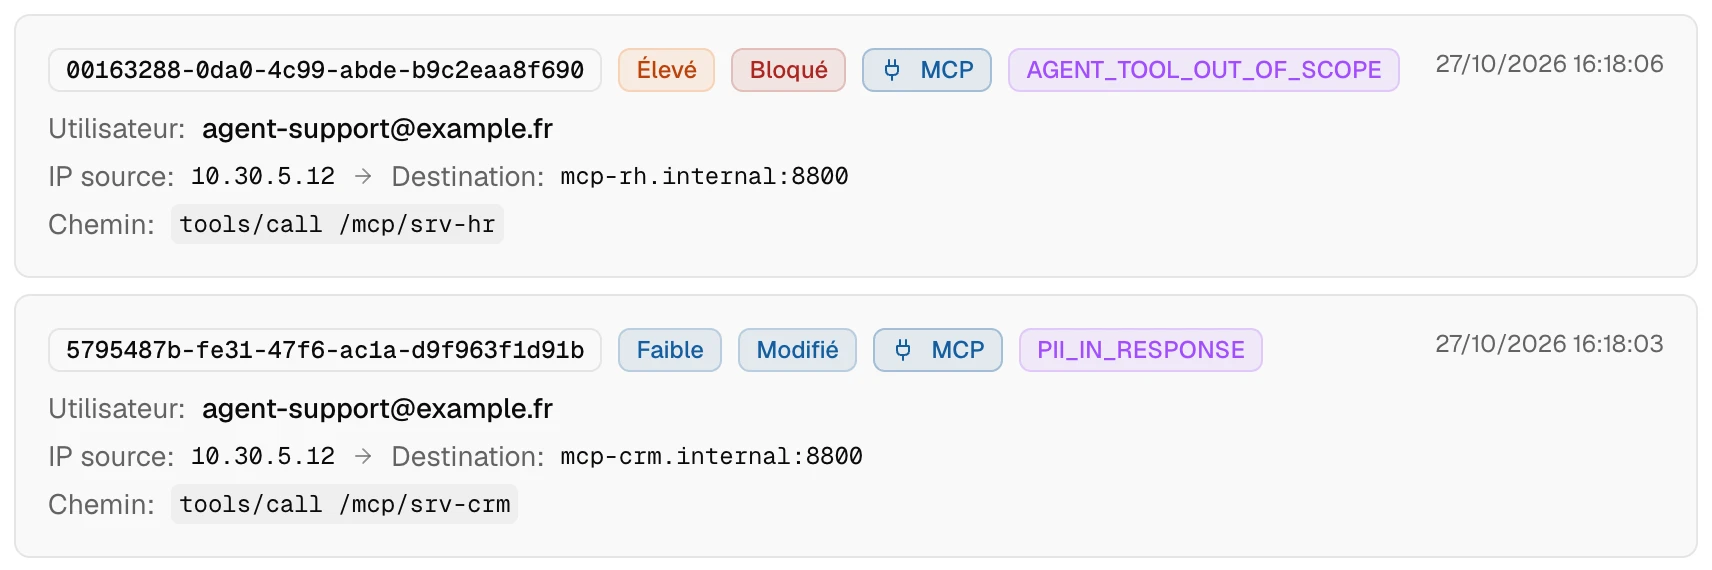
Un agent support qui lit la base RH : chaque serveur MCP branché élargit son périmètre.
Référence : OWASP LLM06
-
Boucles & dérive
Un agent en boucle brûle un budget trimestriel en une nuit, sans que votre APM le voie.
Référence : OWASP LLM10
De l’autonomie, oui.
Sans chèque en blanc.
- Périmètre par agent. Outils MCP déclarés, signés, révocables ; secrets à durée courte.bloqué
- Retours d’outils inspectés. Traités comme une entrée hostile, avant que l’agent ne les lise.modifié
- Validation humaine. Sur l’irréversible, l’agent prépare, un humain nommé signe. Double signature possible.à valider
- Plafonds par run. Étapes, durée, coût. Au-delà, arrêt immédiat et alerte SIEM.arrêté
Ce que votre comité d’architecture va demander.
Et si la gateway tombe ?
Fail-closed par défaut. Un appel que la gateway ne peut ni arbitrer ni journaliser ne part pas. Fail-open possible par équipe, signalé tant qu’il dure.
Seule exception, non réglable : les actions irréversibles restent fail-closed, toujours.
Combien de latence ajoutée ?
Un chiffre que nous ne publions pas. Trois postes : politique, guardrails, écriture du journal.
Le surcoût se mesure sur votre trafic pendant l’évaluation, et ce chiffre-là est contractualisable.
Qui l’opère, et où ?
- SaaS souverain Nous opérons, en Europe, et en France pour les périmètres régulés, journaux d’audit compris.
- Cloud privé dédié Nous opérons une instance rien qu’à vous, dans la région de votre choix.
- Votre infrastructure Vous opérez une stack conteneurisée.
Sur votre infrastructure, nous n’avons aucun accès.
Qui peut lire vos données.
Aucun accès opérateur à vos données, sauf en réponse à incident, avec votre accord explicite — et cet accès est journalisé.
- Rien ne nous revient
- Ni télémétrie produit, ni collecte d’usage, ni entraînement sur vos prompts, dans les trois modes de déploiement.
- Journal en écriture seule
- Chaque appel et chaque action d’agent, horodatés, exportables vers votre SIEM.
- Chemin de l’inférence
- Modèle local (vLLM, Ollama) : vos prompts restent chez vous. Modèle distant : seuls les fournisseurs que vous configurez les reçoivent.
Hébergé chez un fournisseur cloud européen certifié ISO 27001, 27017 et 27018, ou installé sur site en auto-hébergement. RGPD, EU AI Act, DORA et NIS2 ont guidé l’architecture dès la première ligne.
Vous avez déjà eu cette conversation. J’étais de l’autre côté de la table.
Dix ans d’avant-vente en cybersécurité, chez les éditeurs qui équipent déjà votre SOC : Sophos, Trend Micro, VMware Carbon Black, Varonis.
Vérifier sur LinkedIn (nouvel onglet)Tout commence par une évaluation.
Un cas d’usage, sur votre trafic réel, pendant quelques semaines, avec un ingénieur. Ensuite, vous payez la gateway, jamais un pourcentage sur vos tokens.
-
Évaluation
Vous choisissez le périmètre, nous branchons Helios et mesurons avec vous.
- Journal d’audit complet
- Latence mesurée sur votre trafic
- Un ingénieur avec vous
-
Gateway
En production : tout ce qui appelle un modèle passe par là.
- Modèles & volumes sans plafond
- SSO/SAML · RBAC · budgets
- Fail-closed réglable par périmètre
-
Gateway + Agents
Les deux piliers, pour des agents qui écrivent dans vos systèmes métier.
- Contrôle MCP & identité d’agent
- Cloud privé dédié ou votre infrastructure
- Astreinte et engagement de service négociés
Un cas d’usage, votre trafic, quelques semaines.
Vous repartez avec la latence mesurée chez vous et un journal lisible par votre RSSI, que vous signiez ou non.